差距只剩0.7分:Kimi马上要追上美国最强闭源模型
来源:深蓝科技
开源权重将于11月4日前发布;公司称已主动删除训练数据中与网络攻击相关的内容,以降低开源后的滥用风险
中国AI公司月之暗面发布了新一代旗舰模型Kimi K3.1 Pro,并声称在一项关键编程基准测试上超过了OpenAI的最新模型。
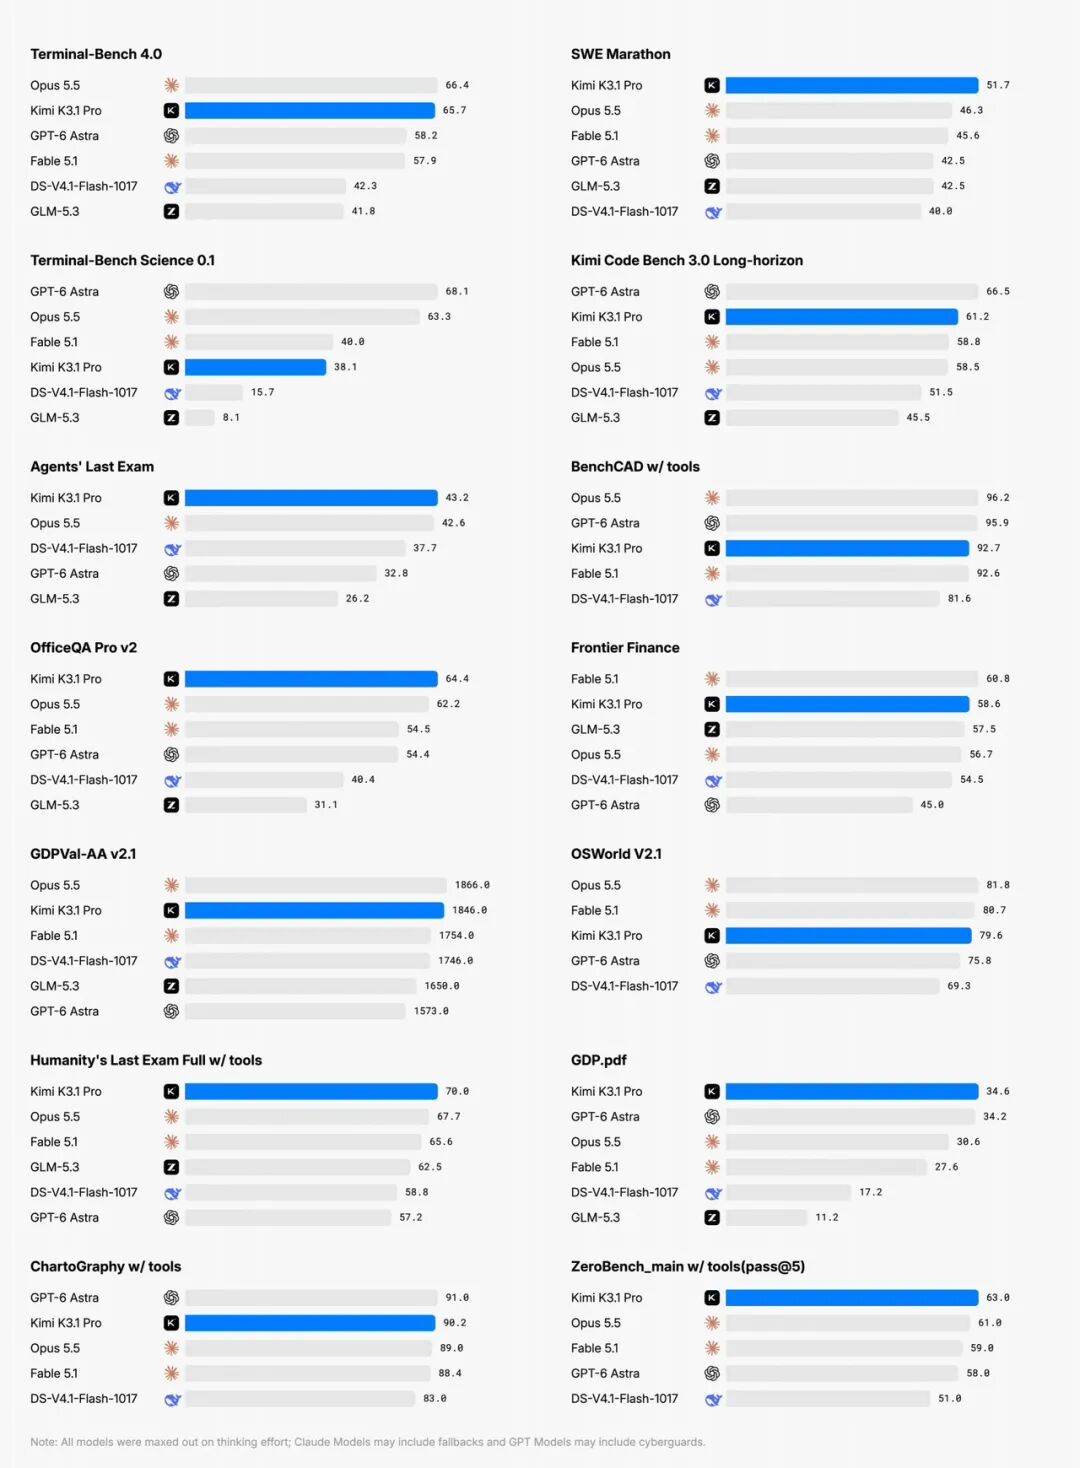
据月之暗面公布的数据,K3.1 Pro在评估AI编程智能体的Terminal-Bench 4.0测试中得分65.7%,高于OpenAI的GPT-6 Astra的58.2%,略低于Anthropic的Claude Opus 5.5的66.4%。这项测试主要考察编程智能体在真实、资源受限的终端环境中完成任务的能力。
K3.1 Pro距离上一代模型Kimi K3发布仅99天。它是在Kimi K3的基础上进行大量后训练得到的升级版本,后者是一个参数规模接近3万亿的模型。K3.1 Pro采用混合专家架构,总参数2.8万亿,每个token激活1040亿参数,支持100万token的上下文窗口。
不只是写代码
月之暗面这次的定位,明显超出了聊天机器人的范畴。公司称,K3.1 Pro能在Unreal、Unity、Godot等游戏引擎中完成完整的项目开发,能在Blender和CAD软件中进行参数化三维建模,在金融相关任务上也明显更可靠,金融建模任务中的幻觉比上一代减少了65%。
在一项内部长程编程测试中,K3.1 Pro基于一个包含296个骨骼组件和402个肌肉组件的开源人体解剖模型,搭建出了一个人体行走动力学模拟器。
在其他测试中,K3.1 Pro并非全面领先。在通过CAD代码生成、从多视角渲染图重建三维模型的BenchCAD测试中,K3.1 Pro在使用工具时得分92.7%,接近Claude Opus 5.5的96.2%和GPT-6 Astra的95.9%。在幻觉测试中,K3.1 Pro使用工具时的错误率为8.3%,较Kimi K3的23.4%大幅下降,但仍高于GPT-6 Astra的5.5%。
Kimi K3.1 Pro Benchmarks
价格更低,权重开源
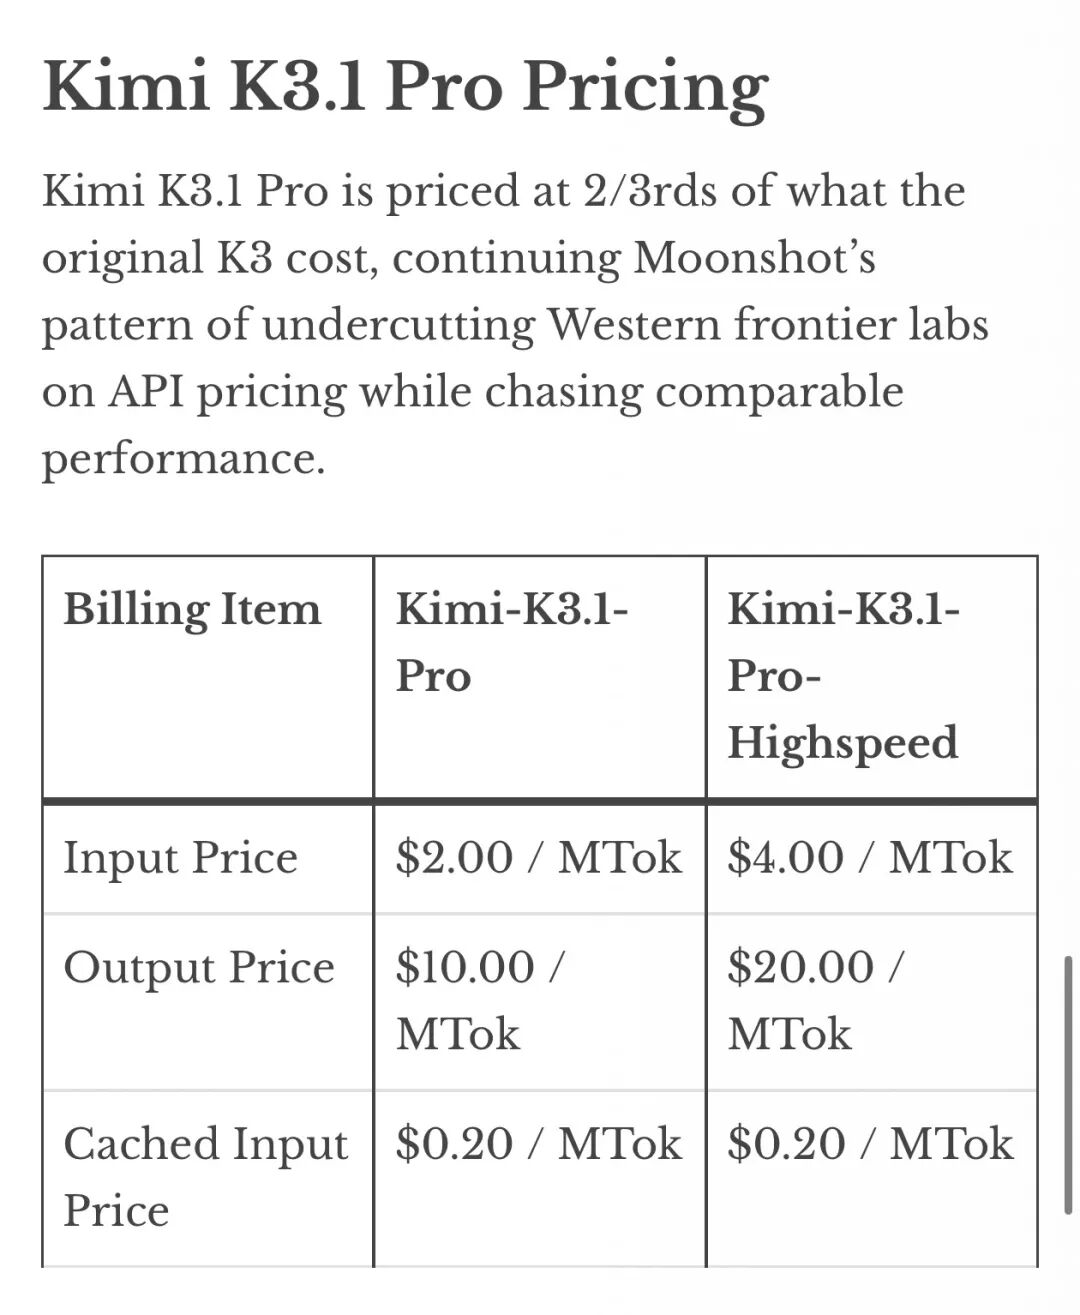
K3.1 Pro的售价只有上一代模型的三分之二。通过第三方平台调用,每百万输入token收费2美元,每百万输出token收费10美元。模型已在Kimi网页版、移动应用、Kimi Work、Kimi Code和API上线,另有一个速度更快的Highspeed版本。Highspeed版本的速度是标准版的2到3倍。
开源是月之暗面的重要筹码。公司表示,K3.1 Pro的完整模型权重将于2026年11月4日前发布。有分析认为,一个可以免费下载、在自己服务器上运行,且在真实编程测试中只落后前沿闭源模型0.7个百分点的模型,会改变企业的算账方式:是订阅Opus或GPT-6,还是自己买GPU来运行Kimi。
主动削弱“黑客能力”
这次发布中最引人注目的,是月之暗面在安全上的取舍。公司称,为了K3.1 Pro的开源发布,它在两个训练阶段都识别并删除了与网络攻击相关的数据,同时保留了保证模型实用性所需的通用编程任务。
删除的效果是可以量化的。在月之暗面内部一项利用真实软件漏洞的测试中,没有经过删减的版本能解决90.5%的任务,最终发布的版本为81%,仍远高于K3的33.3%;月之暗面表示,这一能力仍落后于最好的闭源模型。按月之暗面的统计,竞争对手深度求索的开源模型V4.1-Flash在这项测试中得分85.7%。
成绩有待独立验证
需要注意的是,这些成绩大多来自月之暗面自己的测试。月之暗面公布了14项编程、科学和知识工作评测的结果,其中Terminal-Bench 4.0的成绩由厂商自行测得;对比上一代模型的Kimi Code Bench测试,基准和测试框架都由月之暗面自己掌握,受厂商控制的程度最高。目前这些成绩还没有经过独立验证。
测试条件的差异也会影响结果。在部分测试中,不同模型使用了不同的智能体软件,例如在OfficeQA测试中,GPT-6 Astra使用的是OpenAI的Codex,其他模型使用的是Claude Code。另一家第三方榜单在Terminal-Bench 4.0上列出的最佳成绩属于GPT-6 Astra,为64.6%,K3.1 Pro排在8个模型中的第6位。这说明,同一项测试在不同条件下得出的排名可能差别很大。
但无论排名如何,K3.1 Pro的发布再次说明,中国开源模型与美国最前沿闭源模型之间的差距,正在以“月”为单位缩小。