
来源:深蓝科技
OpenAI周一发布中端模型GPT-6.1 Terra,单价约为Anthropic旗舰模型Claude Opus 5.5的四分之一,在部分测试中的表现与后者相差不到5个百分点。这让AI模型市场的价格竞争进一步升温。
OpenAI表示,新模型即日起向ChatGPT Work和Codex的Plus、Pro、企业版和教育版用户开放,开发者也可通过API调用。其标准API价格为每百万输入token 1美元、输出5美元,是同系列旗舰GPT-6.1 Sol的一半。作为对比,Claude Opus 5.5的标价为每百万输入token 4美元、输出20美元。
发布时间点颇为敏感。同一天,Anthropic向美国证监会公开提交了IPO招股书。据金融时报此前报道,与OpenAI之间的价格战,是Anthropic三季度营收增速放缓的原因之一。
在OpenAI的产品线中,从低到高分为Luna、Terra、Sol和Astra四档。上月发布GPT-6系列时,中端的Terra没有同步更新。
OpenAI在官方博客中重点强调的是成本。公司称,在最高推理强度下,Terra的token效率是Claude Opus 5.5的三倍以上,单价为其四分之一,单任务成本因此低约9倍;完成任务的速度也比GPT-6 Astra和GPT-6.1 Sol快三倍以上。
不过,从OpenAI自己公布的图表看,Opus 5.5在多数测试中仍然领先。
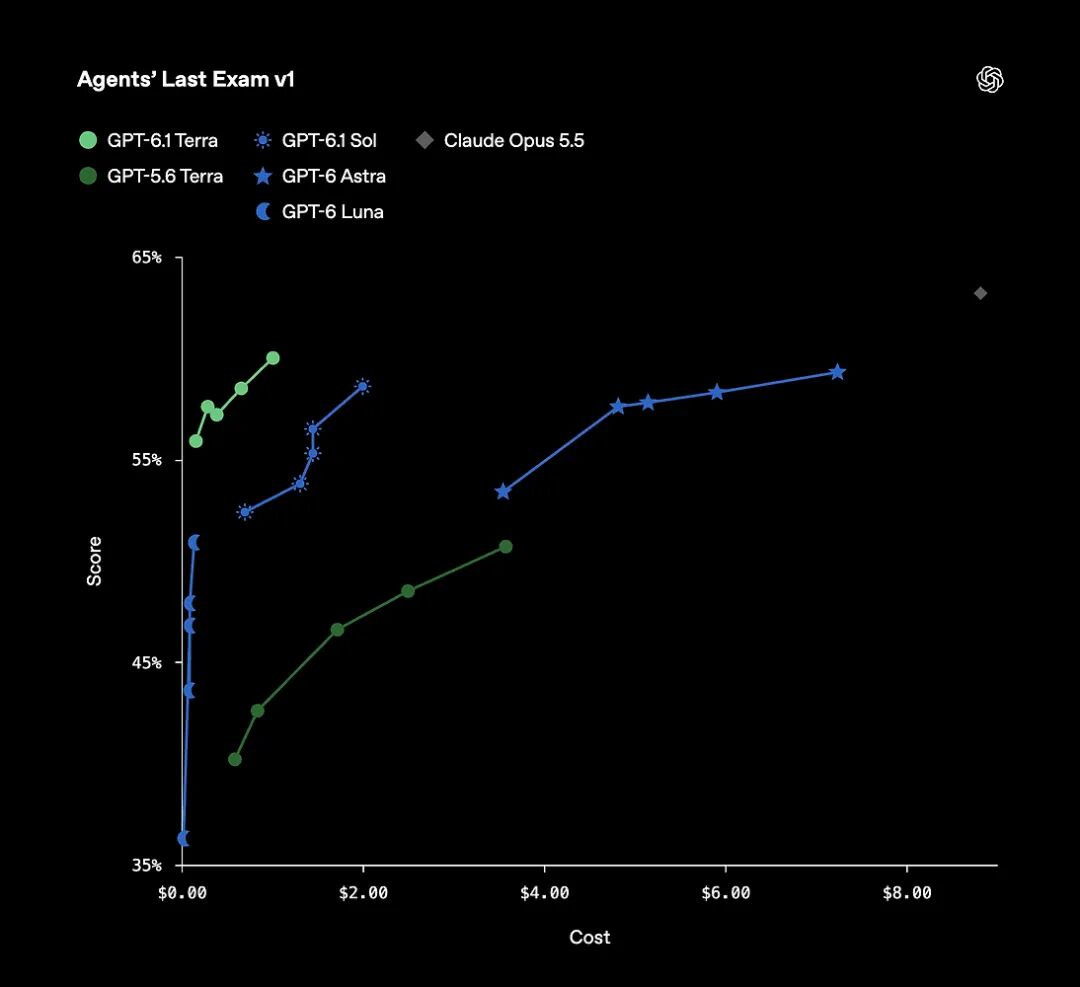
在衡量电脑操作能力的“Agents' Last Exam”测试中,Terra在最高推理强度下得分60.0%,单任务成本1.01美元;Claude Opus 5.5得分63.2%,单任务成本8.82美元。
编程方面,在测试命令行编程能力的Terminal-Bench 4.0上,Terra在最高推理强度下解决了50.3%的任务,是上一代GPT-5.6 Terra的两倍多。但Anthropic公布的Opus 5.5在同一测试中的得分为66.4%。两者相差约16个百分点。
“差距不到5分、成本不到五分之一”的说法,来自一项范围更窄的测试。OpenAI称,在科学计算编程测试Terminal-Bench-Science上,Terra在最高推理强度下超过了GPT-6.1 Sol,与Opus 5.5的差距在5个百分点以内,估算成本不到后者的五分之一。
第三方评测给出的结论类似。独立评测机构Artificial Analysis的编程智能体指数显示,Terra得分48,比GPT-6.1 Sol低6分,比GPT-6 Luna高17分。在同一指数中,Claude Opus 5.5得分58,单任务成本5.98美元;Terra为0.40美元。
Artificial Analysis认为,Terra推高了“成本效率前沿”:在最高推理强度下,其综合智能指数比上一代高6分,单任务成本却不到三分之一,从1.40美元降至0.40美元。
准确率是OpenAI强调的另一项改进。OpenAI称,在其内部易诱发错误的提示词测试中,低推理强度下的错误率从上一代的53.6%降至16.7%。
对企业客户而言,这意味着选择题正在变化:最强的模型未必最划算。对于大批量、重复性的编程和办公自动化任务,一个略逊一筹但便宜得多的模型,可能更有吸引力。
这对Anthropic构成直接压力。编程一直是其营收的核心来源,而它即将以上市公司的身份,按季度向投资人交代增长。
